
L’organisation Product & Tech du Boncoin repose sur des Feature Teams mixtes, chacune dédiée à des domaines fonctionnels précis. Au sein de la Feature Team Homepage & Reco, nous gérons l’intégralité de la chaîne, du front-end au Machine Learning, pour proposer des recommandations pertinentes. Ces modules suggèrent des contenus ou des annonces aux utilisateurs à des moments clés : sur la page d’accueil, lors de la consultation d’une annonce ou via la recherche par image.
C’est sur ce périmètre que nous avons voulu construire une première base de tests de non-régression sur des parcours web critiques.
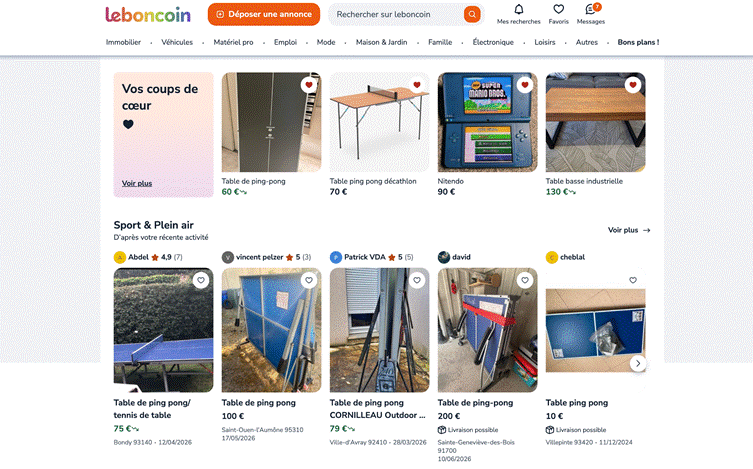
L’objectif était de sécuriser certains widgets (ici, par “widget”, on parle des différents blocs de recommandation) visibles sur la homepage en s’appuyant sur Claude Code, Playwright et son MCP.
Playwright est un outil d’automatisation de tests end-to-end : il permet de piloter un navigateur comme le ferait un utilisateur, puis de vérifier que les comportements attendus sont bien présents à l’écran. Le MCP, pour Model Context Protocol, permet quant à lui à Claude d’interagir plus concrètement avec le navigateur.
L’idée n’était pas seulement de générer quelques scripts, mais de comprendre jusqu’où l’IA pouvait nous aider à construire une base de tests fiables, maintenables et partageables avec l’équipe.
Je suis Audrey, Quality Assurance Analyst chez leboncoin. Je ne suis pas développeuse à l’origine, et je partais de zéro sur la création de tests automatisés et Playwright. Cette expérimentation a donc aussi été un apprentissage : comprendre le code que l’IA générait, savoir le challenger, puis transformer des premiers essais en une base de tests réellement exploitable.
Ce retour d’expérience s’adresse surtout aux QA et équipes produit qui se demandent comment utiliser l’IA pour accélérer l’automatisation, sans perdre de vue ce qui fait la valeur d’un test : sa capacité à sécuriser un vrai comportement utilisateur.
Pourquoi vouloir automatiser ces tests ?
L’objectif n’était pas d’automatiser pour automatiser. Sur des parcours comme la homepage ou les widgets de recommandation, une régression peut avoir un impact direct sur l’expérience utilisateur : moins de contenus pertinents affichés, moins de fluidité dans la découverte d’annonces, ou tout simplement une perte de confiance dans le produit.
Pour moi, en tant que QAA, l’automatisation permettait d’abord de sortir d’une logique de vérification manuelle répétitive. L’idée était de gagner du temps sur les contrôles récurrents pour me concentrer davantage sur ce qui apporte le plus de valeur : comprendre les risques, challenger les parcours, analyser les comportements inattendus et améliorer la qualité des tests.
Pour l’équipe et pour l’entreprise, l’intérêt était aussi de créer un signal de qualité plus régulier et plus partagé. Une suite de tests de non-régression fiable peut aider à détecter plus tôt certaines anomalies, sécuriser les évolutions produit, réduire le risque de régression sur des parcours importants et donner plus de confiance au moment de livrer.
Mais cette valeur n’existe que si les tests sont réellement fiables. Automatiser un test instable ou mal cadré ne réduit pas le risque : cela peut au contraire créer du bruit ou une fausse impression de sécurité. C’est pour cela que la question de la fiabilité est devenue centrale dans cette expérimentation.
Assez vite, une première évidence s’est imposée : l’IA peut accélérer l’écriture des tests, mais elle ne garantit pas leur fiabilité à elle seule.
Elle peut produire du code rapidement. Elle peut proposer une structure. Elle peut aider à débloquer une situation. Mais un test généré vite n’est pas forcément un test utile. Et un test qui passe n’est pas forcément un test qui protège réellement le produit.
C’est cette différence entre générer un test et construire un test fiable qui a guidé toute l’expérimentation.
Commencer par les bons parcours
Avant même de parler d’IA ou de Playwright, il a fallu répondre à une question essentielle : qu’est-ce qu’on automatise en premier ?
Sur Reco, plusieurs zones pouvaient être candidates : les widgets de recommandations sur la homepage, les annonces récemment vues, les favoris, les annonces similaires sur la page annonce, aussi appelée adview en interne. Ces parcours ont une vraie importance dans l’expérience utilisateur, mais ils n’ont pas tous la même criticité, la même stabilité (dû à la complexité de la feature ou de son caractère aléatoire), ni le même intérêt à être automatisés en phase un.
Le premier choix structurant a donc été de ne pas chercher à tout couvrir.
Nous avons priorisé les parcours selon plusieurs critères : la criticité business, le nombre d’utilisateurs concernés, la stabilité des données, l’automatisabilité du parcours et la valeur UX. La cible prioritaire était claire : commencer par des parcours critiques, fréquents, relativement stables, et plutôt orientés “happy path”, ceux où une régression aurait un impact direct sur la découverte d’annonces par l’utilisateur.
Ce choix peut sembler évident, mais il est fondamental. L’IA donne parfois l’impression que l’on peut produire beaucoup, très vite. Pourtant, automatiser un parcours instable, peu utilisé ou mal cadré reste coûteux en temps et en maintenance, même avec un assistant de code. Le test sera peut-être rapide à générer, mais il demandera ensuite beaucoup d’efforts pour être stabilisé, relu, compris et maintenu.
Le premier garde-fou n’a donc pas été technique. Il a été méthodologique.
Le piège du “crée-moi un test”
Au début, ma manière de travailler avec Claude était assez directe.
Je pouvais lui demander de créer un test à partir d’une consigne simple : aller sur une page, gérer l’authentification, vérifier la présence d’un widget, contrôler qu’il contient un certain nombre d’annonces.
Et effectivement, Claude pouvait produire un test.
Mais très vite, plusieurs difficultés sont apparues. Les prompts étaient parfois trop flous. Les étapes étaient implicites. Les sélecteurs, qui permettent de cibler un élément dans la page, pouvaient être approximatifs. Certaines validations semblaient correctes, mais ne prouvaient pas réellement le comportement attendu. Dans certains cas, le test pouvait passer sans que l’on soit complètement sûr de ce qu’il validait.
C’est probablement l’un des apprentissages les plus importants de cette expérimentation : l’IA remplit les trous.
Quand une consigne manque de précision, elle propose une solution plausible, voire une réponse incorrecte ou hallucination. C’est très pratique pour avancer vite, mais risqué pour de la non-régression. Car un test automatisé ne doit pas seulement exécuter un scénario. Il doit apporter une garantie.
Un test qui vérifie vaguement qu’un élément existe n’a pas la même valeur qu’un test qui vérifie explicitement une règle métier attendue, avec des conditions d’échec claires.
Autrement dit : le problème n’était pas que l’IA écrivait mal les tests. Le problème était qu’elle pouvait écrire exactement le test correspondant à une demande que j’avais mal formulée.
Passer du prompt au brief
Le vrai déclic est venu d’un changement de méthode.
Au lieu de demander directement à Claude de générer un test, j’ai commencé à rédiger un brief plus précis. Ce brief devait décrire le contexte, les prérequis, les données, les étapes, les contraintes, les validations attendues et les règles strictes d’échec.
C’est une bonne pratique quand on travaille avec l’IA, et la génération de tests n’échappe pas à cette règle : plus le besoin est clair, plus le test généré a des chances d’être pertinent, compréhensible et vérifiable.
Par exemple, une demande du type :
“Vérifie que le widget “Vos coups de cœur” est présent.”
devient beaucoup plus fiable si elle est formulée ainsi :
“Après authentification et gestion de Didomi (gestion des cookies), rends-toi sur la homepage. Vérifie strictement que le titre “Vos coups de cœur” est présent pour l’utilisateur. Si ce titre n’est pas présent, le test doit échouer.”
La différence n’est pas seulement une question de formulation. Elle change la qualité du résultat attendu.
Dans le premier cas, Claude peut interpréter. Dans le second, il dispose d’une règle claire. Et cette règle peut être relue, challengée et vérifiée par un humain.
Petit à petit, la méthode s’est stabilisée autour de quatre étapes :
- Rédiger un brief précis ;
- Demander à Claude si le brief est développable en l’état ;
- Générer le test, puis relire le code et les assertions, ou les faire relire par des personnes plus expérimentées ;
- Observer le test dans le temps, sur plusieurs runs.
La question “est-ce développable en l’état ?” a été particulièrement utile. Elle permettait de ne pas utiliser l’IA uniquement comme un générateur de code, mais aussi comme un outil de challenge du besoin.
Avant d’écrire le test, Claude pouvait signaler une ambiguïté, une donnée manquante, une assertion trop vague ou un risque de flakiness (c’est le risque que le test soit instable et échoue de manière intermittente sans vraie régression produit). Cela ne remplace pas la relecture QA ou dev, mais cela aide à mieux cadrer le travail dès le départ.
La fiabilité ne vient pas du code seul
Une fois les premiers tests écrits, un autre sujet est devenu central : la confiance dans le résultat.
Deux risques ont guidé notre vigilance.
Le premier est le faux positif : le test dit OK alors que le produit ne fonctionne pas correctement. C’est le cas le plus dangereux, car il donne une fausse impression de sécurité.
Pour le limiter, nous avons renforcé les assertions métier, réduit le périmètre aux parcours les plus maîtrisables, utilisé des données plus stables, cadré les tests avec des briefs plus stricts, et fait relire les vérifications clés pour s’assurer que le test validait bien le comportement attendu.
Le second risque est le faux négatif : le test dit KO alors que le produit fonctionne. Celui-ci génère du bruit, fait perdre du temps, et peut progressivement dégrader la confiance dans la suite de tests.
Pour le réduire, nous avons travaillé sur des sélecteurs plus robustes, des attentes explicites sur les états, des revues de code, et une analyse régulière des tests flaky.
C’est aussi pour cela que nous avons mis en place des alertes en cas de fail ou de test flaky. Elles permettent de rendre ces signaux visibles rapidement, d’analyser leur cause et d’éviter que l’instabilité ne s’installe dans la suite de tests.
C’est à ce moment-là que cette phrase est devenue un repère :
Un test automatisé n’a de valeur que s’il échoue quand il doit échouer.
Elle résume bien l’enjeu. L’objectif n’est pas d’avoir une suite de tests verte à tout prix. L’objectif est d’avoir une suite capable de remonter les bons signaux, au bon moment.
Et cette fiabilité ne se décrète pas au moment où le test est généré. Elle se construit dans le temps.
Du local à une base partagée
Le projet a commencé de manière assez artisanale, sur un repo local. Cette phase était nécessaire pour apprendre : faire tourner un premier test Playwright, comprendre Claude Code, tester MCP Playwright, ajuster les prompts, identifier les limites.
Mais le local a vite montré ses limites.
Un lancement manuel n’est pas suffisant pour une logique de non-régression. Un cron local peut sembler être une solution rapide, mais il reste fragile : machine en veille, VPN, exécution non garantie, accès limité pour les autres membres de l’équipe.
La suite s’est donc construite autour d’un repo GitHub partagé, co-construit par la guilde QAA : une GitHub Action quotidienne, une mise à jour automatique d’un dashboard HTML et une alerte Slack sur un canal dédié.
Cette étape a changé la nature du projet. Les tests n’étaient plus seulement des scripts que je pouvais lancer sur ma machine. Ils devenaient un signal visible, partagé, discutable par l’équipe, et donc améliorable collectivement.
Le dashboard a aussi joué un rôle important. Le rapport natif Playwright était utile, mais pas toujours suffisant pour suivre simplement l’état des runs, la stabilité des tests ou les cas flaky. Avec l’aide de l’IA, j’ai donc construit un dashboard plus lisible, pensé d’abord pour répondre à un besoin QA : mieux comprendre l’état de la base, identifier les tests instables et rendre la qualité plus visible pour l’équipe.
Ce que le MCP Playwright a changé
L’utilisation de MCP Playwright a marqué une étape importante dans l’expérimentation.
Avant, Claude m’aidait surtout à écrire du code à partir de ce que je lui décrivais. Avec MCP Playwright, il pouvait interagir plus directement avec le navigateur : ouvrir une page, identifier les éléments disponibles, cliquer, saisir du texte, observer l’état de la page et m’aider à comprendre où le scénario bloquait.
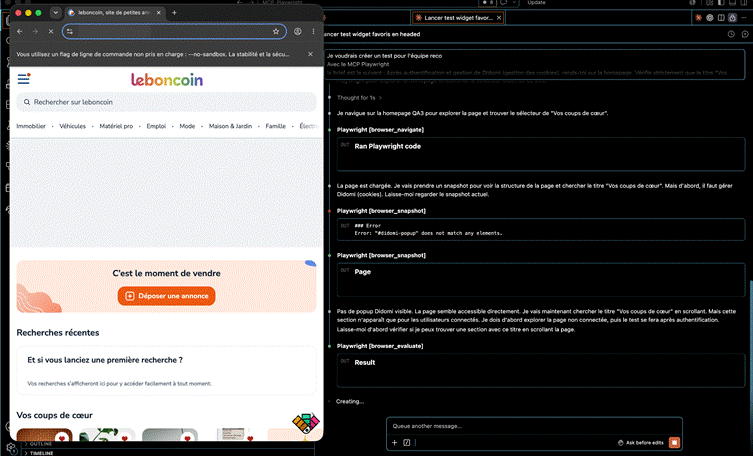
Pour moi, qui ne partait pas d’un profil développeuse, c’était un vrai accélérateur d’apprentissage. Je pouvais mieux suivre ce que le test faisait réellement, comprendre pourquoi un élément était ciblé, voir quand le scénario ne se comportait pas comme prévu, puis ajuster mon brief ou mes assertions.
Cela a rendu la collaboration avec Claude plus concrète. On n’était plus uniquement dans une logique où je décrivais un parcours et où l’IA générait du code “à l’aveugle”. MCP Playwright apportait plus de contexte sur l’état réel de la page, ce qui facilitait le debug et les corrections.
Mais cela ne change pas le fond du sujet : MCP Playwright donne plus de contexte à l’IA, il ne décide pas à notre place de ce qui est important fonctionnellement. La valeur du test reste dans le cadrage QA : le parcours choisi, la règle métier à vérifier, l’assertion attendue et le comportement qui doit faire échouer le test.
Du POC au Starter Kit
L’expérimentation a aussi contribué à alimenter un Starter Kit pour la guilde QAA. L’objectif était de permettre à d’autres QAA de démarrer plus vite, sans repartir d’une page blanche, tout en gardant un cadre suffisamment sécurisé pour expérimenter.
À ce stade, nous avons fait le choix de ne pas partir directement sur un repo commun. Comme il s’agissait encore d’un POC, l’idée était plutôt que chaque QAA puisse dupliquer le Starter Kit dans son propre repo, tester des approches, se tromper, casser des choses et apprendre sans risque d’impacter le travail des autres.
Ce n’était donc pas un choix contre la mutualisation, mais une étape intermédiaire : d’abord permettre à chacun de s’approprier la base dans un espace isolé, puis capitaliser sur ces retours pour construire ensuite un repo commun plus robuste.
Le Starter Kit sert donc de base de départ : une structure, de la configuration, des exemples fonctionnels, des tests on-demand, une alerte Slack optionnelle, des agents comme test generator, test healer ou test planner, et surtout une manière de ne pas refaire seule les mêmes erreurs de départ.
Dans un second temps, l’objectif serait d’aller vers un repo commun avec des règles de contribution, de review et de maintenance partagées.
L’intérêt sera aussi de confronter les approches : voir comment d’autres QAA choisissent leurs parcours, formulent leurs briefs, stabilisent leurs données de test ou décident qu’un scénario n’est pas encore prêt à être automatisé.
Alors, l’IA peut-elle garantir la fiabilité des tests ?
Pas seule.
L’IA m’a clairement aidée à aller plus vite : générer une première version, comprendre Playwright, itérer, corriger, construire un dashboard et rendre l’automatisation plus accessible.
Mais elle n’a pas rendu les tests fiables par magie. Un test généré reste une proposition. Il faut encore vérifier ce qu’il prouve vraiment, renforcer ses assertions, observer ses résultats dans le temps et comprendre ses échecs.
C’est pour ça que cette expérimentation valait le coup : l’IA a réduit le temps nécessaire pour passer d’une idée d’automatisation à une première version exploitable. Elle m’a aussi permis d’aller plus loin que ce que j’aurais probablement pu faire seule dans le même délai, notamment en automatisant de bout en bout une nouvelle feature avant sa sortie.
Le temps gagné n’a pas supprimé le travail QA, il a déplacé ma valeur ajoutée. En automatisant plus rapidement certaines vérifications répétitives, j’ai pu consacrer plus de temps à des sujets plus qualitatifs : analyser les risques, challenger les règles métier, mieux cadrer les scénarios, questionner les cas limites, et travailler avec l’équipe sur ce que l’on veut vraiment protéger côté utilisateur.
Les prochains challenges sont assez clairs.
Il faut continuer à fiabiliser les tests existants, réduire le bruit lié aux flaky tests, améliorer les données de test et renforcer les règles de review.
Mais l’enjeu principal reste le même : garder cette approche au service d’une QA plus proactive, plus proche du produit et des usages réels.
Au final, je ne dirais pas que l’IA garantit la fiabilité des tests. Je dirais qu’elle accélère le chemin vers une base fiable, à condition de garder une chose au centre : l’intention qualité.
Parce qu’un test fiable ne commence pas avec du code. Il commence avec ce que l’on veut vraiment prouver.
À propos de l’auteur : Audrey Moulins est Senior QA Analyst chez leboncoin, avec plus de 6 ans d’expérience en Quality Assurance. Elle accompagne les équipes sur les pratiques qualité, la stratégie de test, l’automatisation et le suivi des indicateurs qualité, tout en explorant l’usage de l’IA comme levier d’apprentissage et de fiabilisation.


